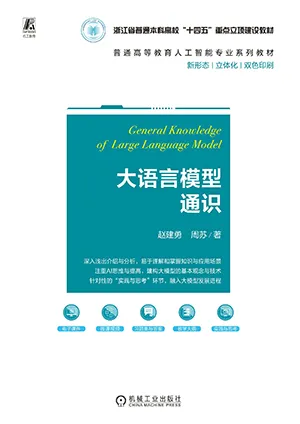
大語言模型通識 內容簡介
隨著信息技術的發展,大語言模型已然成為自然語言處理領域的重要基石,並持續推動著人工智能技術的進步和社會應用的拓展。學習大語言模型課程不僅有利於個人專業成長,更能對社會進步和技術創新產生積極影響。人工智能及其大語言模型技術,是每個高校學生甚至社會人所必須關注、學習和重視的知識與現實。
本書介紹的大語言模型知識主要包括:概述、大模型基礎、大模型的架構、數據標注、大模型預訓練數據、大模型的開發組織、分布式訓練、提示工程與微調、強化學習方法、基於大模型的智能體、大模型應用框架、技術倫理與限 製、大模型的評估和大模型的健康未來等。
本書特色鮮明、易讀易學,適合高等院校、職業院校的人工智能、信息技術相關專業學生學習,也適合對人工智能以及大語言模型相關領域感興趣的讀者閱讀參考。
大語言模型通識 作者簡介
周蘇,男,1958年出生,蘇州人。浙江大學城市學院教授,清華大學訪問學者,科技部相關機構認證創新工程師(二級),清華大學《計算機教育》雜誌“周蘇專欄”作者。周蘇教授的主要教學和研究方向為軟件工程、操作係統和多媒體技術等,僅從自1999年參加獨立學院工作以來,潛心體驗大眾化教育背景下的教學活動並探索其規律,認真踏實地進行教改研究,在教材研究與建設,教學方法改革與創新等方麵積累了豐富的經驗。
大語言模型通識 目錄
前言課程教學進度表
第1章概述1
1.1人工智能基礎1
1.1.1人工智能的定義1
1.1.2人工智能的實現途徑2
1.1.3機器學習和深度學習3
1.1.4監督學習與無監督學習4
1.2大語言模型的定義5
1.3大語言模型形成基礎6
1.3.1Blockhead思維實驗7
1.3.2大模型的歷史基礎7
1.3.3基於Transformer模型8
1.3.4大模型的學習能力9
1.3.5大模型的世界模型問題9
1.3.6文化知識傳遞和語言支持10
1.4通用人工智能11
1.4.1什麼是通用人工智能11
1.4.2大模型與通用人工智能11
1.4.3人工智能生成內容12
【作業】13
【實踐與思考】了解典型的開源大語言模型14
第2章大模型基礎17
2.1什麼是語言模型17
2.1.1語言模型的定義17
2.1.2注意力機製18
2.1.3開源還是閉源19
2.2大模型發展三階段21
2.2.1基礎模型階段21
2.2.2能力探索階段21
2.2.3突破發展階段22
2.3Transformer模型22
2.3.1Transformer過程22
2.3.2Transformer結構25
2.3.3Transformer模塊26
2.4生成式預訓練語言模型GPT27
2.5大模型的結構28
2.5.1LLaMA的模型結構28
2.5.2LLaMA的注意力機製28
【作業】30
【實踐與思考】基於ChatGPT的免費工具:ChatAI小組件31
第3章大模型的架構35
3.1大模型生成原理35
3.1.1上下文學習36
3.1.2指令微調37
3.1.3零樣本/少樣本37
3.1.4深度學習架構37
3.1.5訓練策略及優化技術38
3.2多模態語言模型38
3.2.1多模態指令微調39
3.2.2多模態上下文學習39
3.2.3多模態思維鏈40
3.2.4大模型輔助視覺推理40
3.3應用技術架構41
3.3.1指令工程41
3.3.2函數調用42
3.3.3檢索增強生成42
3.3.4微調42
3.4OpenAI的Sora大模型42
3.4.1Sora技術報告分析43
3.4.2Sora主要技術特點43
3.4.3Sora的模型訓練過程43
3.5穀歌的新款大模型頻發44
3.5.1Gemini1.0大模型44
3.5.2Gemini1.5多模態大模型45
3.5.3Gemma開源大模型48
3.5.4Genie基礎世界模型48
3.5.5什麼是世界模型48
【作業】49
【實踐與思考】熟悉阿裏雲大模型—通義千問51
第4章數據標注54
4.1知識與知識表示54
4.1.1知識的概念54
4.1.2知識表示方法56
4.1.3表示方法的選擇57
4.2什麼是數據標注59
4.3數據標注的分類60
4.3.1圖像標注60
4.3.2語音標注61
4.3.33D點雲標注61
4.3.4文本標注62
4.4製定標注規則62
4.5執行數據標注63
4.6標注團隊管理65
【作業】66
【實踐與思考】熟悉百度大模型—文心一言68
第5章大模型預訓練數據72
5.1數據來源72
5.1.1通用數據72
5.1.2專業數據73
5.2數據處理74
5.2.1質量過濾74
5.2.2冗餘去除75
5.2.3隱私消除75
5.2.4詞元切分75
5.3數據影響分析76
5.3.1數據規模77
5.3.2數據質量77
5.4典型的開源數據集78
5.4.1Pile78
5.4.2ROOTS79
5.5數據集麵臨的挑戰81
5.5.1數據集規模和質量待提升81
5.5.2大模型與數據集相輔相成81
5.5.3數據集標準規範需健全82
5.5.4數據存儲性能待提高83
【作業】83
【實踐與思考】熟悉GlobeExplorer智能搜索引擎86
第6章大模型的開發組織88
6.1大模型開發流程88
6.2大模型的數據組織90
6.2.1數據采集91
6.2.2數據清洗和預處理91
6.2.3數據標注92
6.2.4數據集劃分93
6.2.5模型設計93
6.2.6模型初始化94
6.2.7模型訓練94
6.2.8模型驗證95
6.2.9模型保存95
6.2.10模型測試96
6.2.11模型部署96
6.3訓練集、驗證集、測試集的不同之處97
6.3.1目的與功能不同97
6.3.2數據交互頻率不同97
6.3.3數據劃分與比例不同98
6.3.4使用時機不同98
6.4訓練集、驗證集、測試集的相似之處98
6.4.1數據來源一致99
6.4.2相似的數據預處理99
6.4.3目標一致,各具獨立性99
6.4.4保證數據質量和代表性99
【作業】100
【實踐與思考】熟悉科大訊飛大模型—訊飛星火認知102
第7章分布式訓練106
7.1分而治之106
7.1.1消息傳遞接口MPI107
7.1.2MapReduce107
7.1.3批處理和流處理108
7.2什麼是分布式處理109
7.2.1分布式處理的特點109
7.2.2分布式處理的發展過程110
7.2.3分布式構成方式110
7.2.4分布式處理係統111
7.3分布式訓練概述111
7.4分布式並行訓練策略112
7.4.1數據並行性113
7.4.2模型並行性114
7.4.3流水線並行性115
7.4.4混合並行115
7.5分布式訓練的集群架構116
【作業】117
【實踐與思考】大模型背後的“芯片行業巨頭”—英偉達119
第8章提示工程與微調121
8.1什麼是提示工程121
8.1.1提示工程的本質121
8.1.2提示工程的原理122
8.1.3提示工程應用技術123
8.1.4提示的通用技巧124
8.2大模型為什麼要微調125
8.3提示學習和語境學習126
8.3.1提示學習126
8.3.2語境學習127
8.4上下文窗口擴展128
8.5指令數據的構建128
8.5.1手動構建指令128
8.5.2自動構建指令128
8.5.3開源指令數據集130
8.6微調及其PEFT流行方案130
8.6.1微調技術路線130
8.6.2提示微調130
8.6.3前綴微調131
8.6.4LoRA131
8.6.5QLoRA131
【作業】131
【實踐與思考】熟悉文生圖大模型—Midjourney133
第9章強化學習方法136
9.1什麼是強化學習136
9.1.1強化學習的定義136
9.1.2強化學習的發展歷史137
9.2強化學習與監督和無監督學習的比較138
9.2.1與監督和無監督學習的不同138
9.2.2大模型環境下的強化學習139
9.2.3學習方式不同140
9.2.4先驗知識與標注數據141
9.3強化學習的基礎141
9.3.1基於模型與免模型環境141
9.3.2探索與利用142
9.3.3片段還是連續性任務143
9.3.4網絡模型設計143
9.3.5數據依賴性145
9.4強化學習分類146
9.4.1從獎勵中學習146
9.4.2被動強化學習147
9.4.3主動強化學習147
9.4.4強化學習中的泛化147
9.4.5學徒學習147
【作業】148
【實踐與思考】熟悉文生視頻大模型—Sora149
第10章基於大模型的智能體154
10.1智能體和環境154
10.2智能體的良好行為155
10.2.1性能度量155
10.2.2理性156
10.2.3全知、學習和自主156
10.3環境的本質157
10.3.1指定任務環境157
10.3.2任務環境的屬性158
10.4智能體的結構160
10.4.1智能體程序160
10.4.2學習型智能體161
10.4.3智能體組件的工作163
10.5構建大模型智能體164
10.5.1基於大模型的智能體164
10.5.2觀測與感知164
10.5.3記憶與檢索165
10.5.4推理和規劃166
10.5.5行動和執行167
【作業】168
【實踐與思考】人形機器人創業獨角獸FigureAI170
第11章大模型應用框架172
11.1大模型哲學問題172
11.1.1組成性172
11.1.2天賦論與語言習得173
11.1.3語言理解與基礎173
11.1.4世界模型174
11.1.5知識傳遞和語言支持175
11.2大模型的構建流程175
11.2.1確定需求大小176
11.2.2數據收集176
11.2.3數據預處理177
11.2.4大模型預訓練177
11.2.5任務微調178
11.2.6模型部署178
11.3大模型的應用場景178
11.3.1機器翻譯、文本理解與分析179
11.3.2惡意軟件分析179
11.3.3自然語言生成179
11.3.4搜索與知識提取180
11.3.5代碼開發181
11.3.6檢測和預防網絡攻擊181
11.3.7虛擬助理和客戶支持181
11.3.8轉錄181
11.3.9市場調研181
11.3.10SEO關鍵詞優化181
11.4案例:Magic突破Q算法182
【作業】183
【實踐與思考】精通垃圾分類的ZenRobotics機器人185
第12章技術倫理與限製187
12.1人工智能麵臨的倫理挑戰187
12.1.1人工智能與人類的關係187
12.1.2人與智能機器的溝通188
12.2大數據倫理問題189
12.2.1數據主權和數據權問題189
12.2.2隱私權和自主權問題190
12.2.3數據利用失衡問題190
12.3大模型的知識產權保護190
12.3.1大模型的訴訟案例191
12.3.2大模型生成內容的知識產權保護194
12.3.3尊重隱私,保障安全,促進開放194
12.3.4邊緣群體的數字平等195
12.4算法歧視195
12.4.1算法透明之爭195
12.4.2算法透明的實踐197
12.4.3算法透明的算法說明198
12.4.4算法公平的保障措施199
【作業】200
【實踐與思考】完全由人工智能生成的視覺藝術品無法獲得版權201
第13章大模型的評估204
13.1模型評估概述204
13.2大模型評估體係205
13.2.1知識與能力205
13.2.2倫理與安全207
13.2.3垂直領域評估209
13.3大模型評估方法210
13.3.1評估指標210
13.3.2評估方法211
13.4大模型評估實踐212
13.4.1基礎模型評估212
13.4.2監督學習和強化學習的模型評估214
【作業】215
【實踐與思考】開展典型大模型評估
實踐217
第14章大模型的健康未來220
14.1人工智能新發展220
14.1.1“人工智能”成為新質生產力重要引擎220
14.1.2人工智能改變自動駕駛未來221
14.1.3重視人工智能治理政策222
14.1.4人工智能音樂的立法實踐222
14.1.5防止人工智能誤導民眾223
14.1.6生成式人工智能產出的版權224
14.2數據隱私保護對策225
14.2.1構建隱私保護倫理準則225
14.2.2注重隱私保護倫理教育226
14.2.3健全道德倫理約束機製226
14.3人工智能倫理原則226
14.3.1職業倫理準則的目標227
14.3.2創新發展道德倫理宣言227
14.3.3百度四大倫理原則229
14.3.4歐盟可信賴的倫理準則229
14.4大模型的大趨勢230
14.5通用人工智能湧現231
【作業】232
【課程學習與實踐總結】234
附錄作業參考答案238
參考文獻241
······
最後修改:2026 年 10 月 26 日
© 允許規範轉載