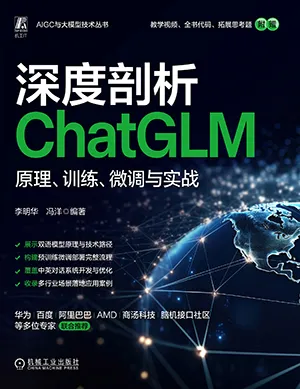
深度剖析ChatGLM 內容簡介
近年來,隨著大語言模型技術的迅猛發展,人工智能領域迎來了新的變革浪潮。ChatGLM作為一款雙語大語言模型,憑借其在多語言生成、精準對話理解和高效推理上的良好表現,成為了自然語言處理領域的重要代表。
本書以ChatGLM模型為核心,係統性地介紹了其從原理、訓練、微調到實際應用的全流程,全麵解析了大語言模型的實現方法與優化策略。全書共分為12章,從基礎原理切入,涵蓋模型架構解析、訓練與微調實現、推理優化、部署集成與性能調優等關鍵技術,同時深入探討數據處理、多任務學習與遷移學習,以及API開發、Web應用搭建與雲端部署的完整方案。本書特別關注ChatGLM在客服、金融、醫療、教育等領域的創新應用,展現了其多樣化的適用能力,並以雙語對話係統為實戰案例,總結了從數據處理到係統部署的完整開發流程。
本書的特色在於理論與實踐並重,注重案例引導與操作指導,特別適合AI初學者、希望深入了解ChatGLM的工程師和研究者,以及希望學習大語言模型的高校師生使用。隨書附贈案例代碼、教學視頻及授課用PPT等海量學習資源,希望通過立體化的學習方式幫助廣大讀者從中獲得係統的知識與啟發。
深度剖析ChatGLM 作者簡介
李明華:曾就職於某知名科技公司,長期從事自然語言處理、機器學習及深度學習等技術的研發與應用,特別是在大語言模型的微調與優化技術方麵具有深厚的學術積澱和實踐經驗。參與並主導了多個企業級AI產品的開發,涵蓋智能客服、編程輔助、智能檢索和硬件工程等應用場景。對大語言模型的原理、優化技術以及工程實踐有著深入的理解。
馮洋:南京大學計算機學院副教授,主要研究方向為複雜軟件係統質量保障、大語言模型研究和應用開發,研究課題包括複雜軟件係統的質量保障技術、大語言模型的微調與優化技術等。近年來發表包括ICSE、FSE、ASE、ISSTA、TSE、TOSEM等CCF-A類期刊與會議學術論文30餘篇,並在2022年ASE、2023年FSE、2023年Internetware等大會獲傑出論文獎及華為火花獎等獎項。
深度剖析ChatGLM 目錄
前言
第1部分ChatGLM的概述與基礎原理
第1章 ChatGLM概述與原理詳解
1.1ChatGLM的發展與應用背景
1.1.1ChatGLM簡介與具體應用
1.1.2對比傳統NLP模型與ChatGLM的優勢
1.2基於Transformer架構的自注意力機製
1.2.1Transformer簡介
1.2.2詳解Transformer編碼器解碼器架構
1.2.3詳解ChatGLM中的自注意力機製
1.2.4Transformer中的多頭注意力機製
1.3ChatGLM的架構分析
1.3.1ChatGLM模型的結構設計
1.3.2ChatGLM與GPT、BERT模型的異同
1.4ChatGLM的應用場景與技術優勢
1.4.1ChatGLM在對話係統中的具體應用
1.4.2ChatGLM對自然語言理解與生成的影響
第2章 ChatGLM模型的訓練流程與技術要點
2.1訓練數據的采集與清洗
2.1.1語料庫的選擇與構建方法
2.1.2數據清洗與標準化技術
2.1.3噪聲數據與異常值處理
2.2訓練任務的設定與損失函數
2.2.1回歸與分類任務的設計
2.2.2適配性損失函數的選擇與實現
2.3模型訓練的實現流程
2.3.1PyTorch與TensorFlow簡介
2.3.2PyTorch與TensorFlow訓練框架的選擇與搭建
2.3.3模型初始化與優化器的選擇
2.4分布式訓練與高效計算
2.4.1數據並行與模型並行的實現細節
2.4.2混合精度訓練(FP16)的應用與性能提升
第3章 ChatGLM的硬件環境與訓練加速
3.1高效硬件配置與訓練需求
3.1.1推薦的GPU與TPU硬件配置
3.1.2內存與存儲的優化技巧
3.2分布式訓練框架:Horovod與DeepSpeed
3.2.1分布式訓練框架簡介
3.2.2Horovod的使用與優化方法
3.2.3DeepSpeed對大語言模型的優化
3.3訓練監控與調優工具
3.3.1訓練監控的目的
3.3.2使用TensorBoard進行訓練監控
3.3.3Hyperparameter優化工具與技術
第2部分ChatGLM的優化與高級技術
第4章 ChatGLM的微調策略與方法
4.1微調的基本原理與應用場景
4.1.1預訓練與微調的區別
4.1.2微調的核心目標與技術要點
4.2領域適應微調技術
4.2.1針對特定領域的數據集微調
4.2.2領域特定嵌入與調優策略
4.3ChatGLM的自適應微調方法
4.3.1動態學習率與早停策略的使用
4.3.2負樣本生成與調整
4.4微調的常見問題與調優技巧
4.4.1微調過程中的過擬合問題
4.4.2針對微調任務的優化技巧
第5章 ChatGLM的生成任務優化與文本生成
5.1生成式任務與非生成式任務的區別
5.1.1生成式任務與分類任務的關鍵差異
5.1.2Text to Text生成與Seq2Seq架構
5.2ChatGLM在文本生成中的應用
5.2.1自回歸與自編碼生成模型的優缺點
5.2.2基於自注意力的生成優化策略
5.3Beam Search與Top k采樣的優化
5.3.1Beam Search與Top k采樣任務簡介
5.3.2生成過程中的采樣方法與性能
5.3.3控製生成內容的多樣性與連貫性
5.4生成式模型調優與文本質量提升
5.4.1提高文本生成的質量與準確度
5.4.2避免模型生成偏見信息的方法
第6章 ChatGLM的優化與性能提升技術
6.1模型壓縮與蒸餾技術
6.1.1模型壓縮與蒸餾技術簡介
6.1.2參數剪枝與低秩分解的實現
6.1.3知識蒸餾方法與應用實例
6.2動態計算圖與推理優化
6.2.1計算圖簡介與初步實現
6.2.2動態計算圖與靜態計算圖的對比
6.2.3ChatGLM推理中的性能瓶頸分析與優化
6.3TensorRT與ONNX的推理加速
6.3.1什麼是推理加速
6.3.2ChatGLM模型的ONNX轉換與優化
6.3.3使用TensorRT進行推理加速與量化
6.4節省內存與計算資源的策略
6.4.1分層微調與多任務學習的內存優化
6.4.2通過混合精度訓練減少內存消耗
第7章 ChatGLM的多任務學習與遷移學習
7.1多任務學習的基本原理與應用
7.1.1如何設計多任務學習模型
7.1.2ChatGLM如何在多任務中共享學習
7.2遷移學習在ChatGLM中的應用
7.2.1微調預訓練模型與領域特定任務
7.2.2遷移已有知識進行新任務學習的方法
7.3多模態學習:圖像與文本融合
7.3.1融合視覺信息與文本信息的技術
7.3.2多模態對話係統的應用
7.4ChatGLM與跨領域任務的適配
7.4.1領域轉移學習的挑戰與解決方案
7.4.2使用少量標注數據進行跨領域遷移學習
第8章 ChatGLM的調優與故障排除
8.1調優原則與技巧
8.1.1如何選擇合適的優化器與學習率
8.1.2調整批量大小與訓練輪數的策略
8.2常見訓練問題的診斷與解決方法
8.2.1模型收斂慢的原因與解決方法
8.2.2模型訓練過程中的梯度消失與爆炸問題
8.3過擬合與欠擬合問題的應對策略
8.3.1過擬合的識別與解決方法
8.3.2欠擬合的原因與優化技巧
第3部分ChatGLM的部署與行業實踐
第9章 ChatGLM的部署與集成
9.1部署架構設計與模型服務化
9.1.1模型服務化的架構與流程設計
9.1.2RESTful API與gRPC的選擇與應用
9.2使用Docker與Kubernetes進行部署
9.2.1使用Docker容器化部署ChatGLM
9.2.2Kubernetes集群中的模型管理與擴展
9.3在線推理與批量推理的實現與優化
9.3.1實時推理與批量推理架構的選擇
9.3.2批量推理中的性能優化技術
9.4部署中的監控與故障恢複
9.4.1日誌記錄與錯誤跟蹤
9.4.2自動化恢複與容錯機製
第10章 AI前沿:ChatGLM的倫理與安全性
10.1AI倫理:ChatGLM麵臨的挑戰與風險
10.1.1偏見與公平性問題
10.1.2數據隱私與信息安全的風險
10.2偏見檢測與消除策略
10.2.1偏見的檢測方法與評估標準
10.2.2如何在訓練數據中消除偏見
10.3模型的透明性與可解釋性
10.3.1可解釋AI與黑箱問題
10.3.2解釋性技術
10.4數據隱私保護技術
10.4.1GDPR與數據隱私合規性
10.4.2同態加密與差分隱私技術
第11章 ChatGLM在行業中的應用案例
11.1ChatGLM在客服係統中的應用
11.1.1電子商務與企業級客服係統的對接
11.1.2自動化問答與多輪對話的實現
11.2ChatGLM在金融領域的應用
11.2.1金融數據處理與自動化谘詢服務
11.2.2風險預測與欺詐檢測
11.3ChatGLM在醫療領域的應用
11.3.1醫療知識圖譜與智能問答係統
11.3.2疾病預測與個性化健康谘詢
11.4ChatGLM在教育領域的應用
11.4.1智能教育助手與個性化學習
11.4.2基於ChatGLM的在線教育平台
第12章 ChatGLM實戰:雙語智能對話係統
12.1項目背景與目標設定
12.1.1項目背景:構建雙語智能對話係統
12.1.2項目目標設定與技術要求
12.1.3需求分析:雙語對話係統的具體需求
12.2數據收集與預處理
12.2.1雙語數據集的收集與構建
12.2.2數據清洗與格式化處理
12.2.3數據增強與多輪對話處理
12.3模型訓練與微調實現
12.3.1訓練雙語模型的架構與流程
12.3.2雙語數據微調
12.3.3模型訓練的優化與技巧
12.4模型部署與性能評估
12.4.1模型部署架構與設計
12.4.2模型實時推理與批量推理的實現
12.4.3模型性能評估與優化
12.5API接口開發
12.5.1API開發概述與需求分析
12.5.2基於Flask/Django框架搭建API服務
12.5.3應用程序雲端部署
12.5.4Web端應用程序部署